正式の広報はまだですが、8月27日(土)/28日(日)にクラウド温泉@小樽が開催される予定です。温泉に浸かりながら、クラウドを肴に語り合いましょう、という企画です。
ここ数年取り組んでいた、ScalaによるDSL駆動開発について、開発していたツールが形になってきたので、クラウド温泉でお披露目する予定です。
DSL駆動開発の軸となるのがScala DSLコンパイラSimpleModelerです。当初は、SimpleModelerでモデルからクラウドプラットフォームのAPI上に対して直接クラウドアプリケーションの生成を試行していたわけですが、適切なアプリケーションフレームワークがないと自動生成もままならない、ということが分かりクラウドプラットフォーム向けにRESTメッセージングフレームワークであるg3を開発しました。
g3はAtomPubメッセージによるRESTを軸としてコンポーネントの連携動作を行うイベント駆動フレームワークです。
g3はデータストアアクセスを含めてTomcatなどのWebサーバとGoogle App Engineの両方で動作します。できるだけ同じプログラムを色々なクラウド・プラットフォームで動作させることがg3の目的の一つです。
また、クラウド時代にはUIが、伝統的なWeb UIからAjaxベースのGUIやスマートデバイスに移行することになります。このところ仕事でAndroidに取り組んでいたこともあり、Android向けのプログラム生成の基盤となるフレームワークg4を作ってみました。
Androidのアプリケーションアーキテクチャは、以前「Androidのアーキテクチャ」で考えてみましたが、これをさらに発展させプログラムの自動生成に対応したものを実装しました。
クラウド温泉のセッションでは、SimpleModelerからg3を使ったGoogle App Engineアプリケーションと、g4を使ったAndroidアプリケーションの自動生成のデモを行う予定です。自動生成したAndroidアプリケーションとGoogle App Engineはもちろん連携動作します。
といいつつ、g3アプリケーション(App Engine)とg4アプリケーション(Android)の自動生成はこれから作るので(汗)、実際にデモまで辿りつけるかは分かりませんが、クラウド温泉を励みにして取り組んでいく予定です。

2011年5月31日火曜日
データストアのアクセス特性
4月の中頃に書いていた記事の続きなんですが、ずいぶん間が空いてしまいました。そこでは、すこしモデリングの話題に寄り道しましたが、ドメインモデルとデータストアのマッピングの話題に戻りたいと思います。
ドメインモデルとデータストアのマッピングを考える上で重要なのがデータストアの分類です。データストアの分類軸として、色々なものが考えられますがその一つとして、データアクセス特性があります。
クラウドプラウドプラットフォームにおけるデータストアの性能特性と、アプリケーションのニーズの対応関係を整理し、アプリケーションの用途に合わせた性能特性を持つデータストアを選択することが重要になります。
RDBMS登場後は、データストアの選択もRDBMS一本でよかったのですが、クラウドプラットフォーム、NoSQLといった新しい技術の登場で、データストアの選択、あるいは使い分けがアーキテクチャ選択上、重要な要因になってきました。
そこで、データストア選択のための評価軸を整理しておくことにしました。現時点で思いつくのがアクセスパターン、アクセス方式、アクセスサイズです。他によいものあれば随時追加していきたいと思います。
アクセスパターン
データストアに対するアクセスパターンとして以下の分類を使用します。
- read-only
- 参照のみ。
- read-write
- 参照と更新。
- read-mostly
- ほとんど参照、まれに更新。
- write-only
- 書き込みのみ。
read-writeが一番汎用的ですが、スケーラビリティの達成が困難になります。
その他の3つのアクセスパターンは、read-writeよりもアクセスの自由度が限定される分、スケーラビリティを高くする事ができます。
read-onlyは文字通り参照のみのアクセスで、更新処理はありません。このパターンでは、データの複製を必要な数だけ用意することができるので、スケーラビリティを高めることができます。
read-mostlyは分散技術でよく用いられる呼び方で、ほとんど参照のみで、たまに更新があるという特性です。この特性と、データの一貫性は厳密に制御しないという方式を組み合わせるとキャッシュを広範囲にわたって配布、共有できるのでスケーラビリティを大幅に向上させることができます。
write-onlyはアプリケーションからは書込みのみを行うパターンです。ログなどが典型例ですが、CQRSといったアーキテクチャではデータ投入にこのアクセスパターンを用います。
read-writeでは、データの一貫性を保つための制御に大きなオーバヘッドあり、write-onlyとすることでこのオーバヘッドを避けることができます。
アクセス方式
アクセス方式として以下の分類を使用します。
- sequential
- シーケンシャルアクセス
- random
- ランダムアクセス
sequentialは、データを先頭から最後尾まで連続でアクセスするアクセスパターンです。先頭から最後尾までの連続アクセスも、さらに索引順と格納順に分けることができますが、現在は索引を持つのが普通(あるいはカラムナDB)なので考えないことにします。
randomは、データを一部をランダムにアクセスするアクセスパターンです。
OLTPはランダムアクセスが中心ですが、バッチ処理やOLAP/BIはシーケンシャルアクセスのニーズが高くなります。
データストアを選択する上で重要なのは、ランダムアクセス性能とシーケンシャルアクセス性能は、多くの場合相反する性質ということです。このため、アプリケーションの特性に応じてデータストア製品を選択するが必要となります。あるいは、RDBMSにおけるインデックスのチューニングといった作業で同じデータベースシステムをシーケンシャルアクセス向けやランダムアクセス向けにチューニング仕分けることも可能です。いずれかの手段で、適切なデータストアを確保することになります。
アクセスサイズ
アクセスサイズとして以下の分類を使用します。
- record
- データをレコード単位でアクセス
- portion
- データの一定範囲をアクセス
- bulk
- データの一定範囲/全体を一括してアクセス
recordはレコード単位でのデータアクセスです。1レコードから数レコードの範囲を想定しています。
portionは一定範囲でのデータアクセスです。データの選択を行った後、一回の転送で取得できる範囲(1000件程度)を想定しています。
bulkはデータの一定範囲あるいは全体を一括アクセスします。データ全体スキャンあるいは選択条件に合致する多量のレコードを一括してアクセスすることを想定しています。
2011年4月15日金曜日
ユースケース
コラボレーションタスク監視起票は、Twitterでの注目発言の発生を監視し、注目発言が発生したときに、この発言に対応するためのタスクを起票するコラボレーションです。
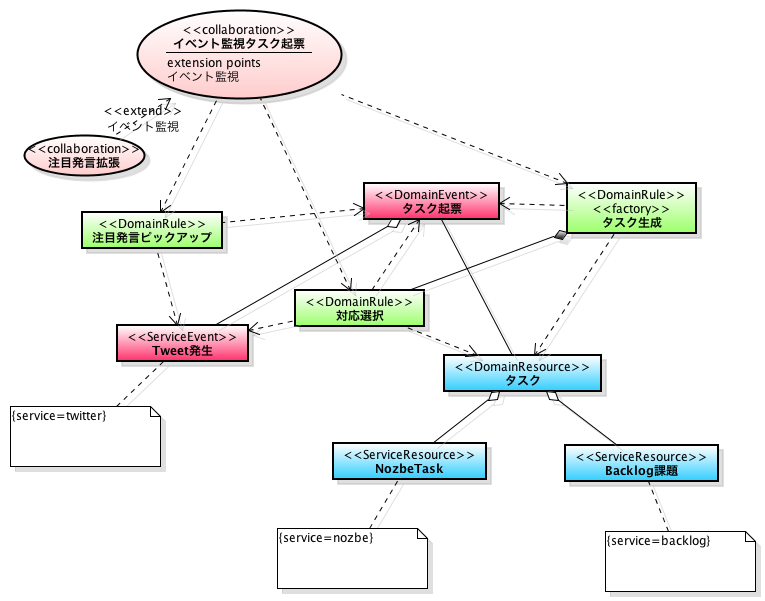
アプリケーション開発におけるモデリング作業の中でこのコラボレーションをどのように抽出してくるのかというのが論点の一つになります。これは、利用者の要求とコラボレーションの結びつけるモデル要素が必要なことを意味しています。
いうまでもなく、このモデル要素とはユースケース(use case)です。ユースケースは、システムの振舞いモデルであると同時に利用者の目的と、目的を達成するための物語を記述したモデル要素です。
ユースケースは、アクターの目的をアクターとシステム間のインタラクションの列として記述します。通常は、自然言語によるシナリオとしてこのインタラクションを記述します。
UMLでは、ユースケースを具象化したものがコラボレーション、コラボレーションを抽象化したものがユースケースという関係になります。
以下の図はコラボレーションイベント監視タスク起票を利用者の要求と結びつけるユースケースであるユースケースイベントを監視して対応するタスクを起票するを追加したものです。ユースケースイベントを監視して対応するタスクを起票するは、利用者視点での利用者とシステムのインタラクションをシナリオとして記述します。
そして、コラボレーションイベント監視タスク起票はこのユースケースイベントを監視して対応するタスクを起票するを実現(realize)する、という関係(relationship)になるわけです。(UMLでは、ユースケースをコラボレーションが実現するという関係を、実現シンボル(典型的にはインタフェースをクラスが実現の用途で使用)で記述できるのですがJudeではサポートしていないようなので、依存(dependency)で記述しています。)

開発の手順としては、問題領域のドメインモデルをざっくりと作りつつ、利用者の要求をユースケースとしてモデル化。ユースケースを実現するためにドメインモデルを調整、という流れになります。
ここで、ユースケースとドメインモデルをつなぐモデル要素としてコラボレーションが登場することになります。このコラボレーションをコードの自動生成の枠組みに結びつけることができれば、自動生成のターゲットが大きく広がります。
SimpleModelerでは、ユースケース、コラボレーションをScala DSLで記述して、(同じくScala DSLで記述した)ドメインモデルと結びつけるような方向でユースケースからコラボレーションを経てドメインモデルに至るトータルなモデリングプラットフォームを提供したいと考えています。
ユースケース周りは、ロバストネス分析など色々とおもしろい話題があるので、SimpleModelingでの扱い、SimpleModelerでのサポート方針といった切り口でブログでも取り上げていきたいと思います。
2011年4月14日木曜日
コラボレーションと拡張点
コラボレーションイベント監視タスク起票は、Twitterでの注目発言の発生を監視し、注目発言が発生したときに、この発言に対応するためのタスクを起票するコラボレーションです。

話のそれついでにコラボレーションに関連するモデリング上の話題を続けます。
コラボレーションの導入はコードの自動生成が重要な目的です。
コード生成を行うためには、模型的な意味で図形が配置されているだけでは情報量は不十分で、より詳細な情報を記述しなければなりません。
このような情報の一つに前回の記事で説明した「ドメインルールはTemplateMethodの骨組みのスロットに差し込む拡張部。アプリケーションの構成定義画面でパラメタの変更が可能」といったものがあります。
つまり、ドメインルールのところで、カスタマイズが可能なわけですが、コラボレーション側でもカスタマイズが必要な場合があります。
この目的に、UML標準部品である拡張点(extension point)を用いることができます。拡張点は(通常はユースケースに使うのですが)コラボレーションのインタラクションの一部を拡張するためのスロット的なポイントです。拡張点名を記述し、それに対する具体的な拡張のコラボレーションを拡張(extend)関係で記述します。
拡張点を用いて、コラボレーションイベント監視タスク起票のより詳細な情報を記述した図が以下のものです。

コラボレーションイベント監視タスク起票は、拡張点イベント監視を持っており、ここに拡張を実現するコラボレーションとしてコラボレーション注目発言拡張を指定しているので、注目発言を監視するコラボレーションとして動作する、というわけです。(補足ですが、この図の趣旨からは、注目発言ピックアップの対象がTwetterとなっているのは、DoainRule注目発言ピックアップの設定、ということになります。
この他にもコラボレーションをカスタマイズするメカニズムとしてステレオタイプ、タグ付き値を使用することができます。
UMLでカスタマイズを記述するとこの図のような形になるわけですが、これでは情報が不足ではないか、と思われるかもしれません。
実際のところ、その通りで、本当にコードの自動生成を行うということであれば、相当量の情報をタグ付き値などを使って設定しなければなりません。
つまるところ、UMLでモデルを記述する場合でも、結局のところ情報の過半数はテキスト情報として入力しなければならないわけです。そうであれば、始めからテキスト形式の言語で記述したほうがよい、というのがSimpleModelerのアプローチです。
テキスト情報から、上記の図レベルのものはプログラムで生成することが可能です。どのコラボレーションにどのような拡張点があるのか、といった情報をざっくり見るにはツールが生成した図を見れば十分であり、わざわざモデリング時に手で入力する必要はないわけです。
SimpleModelerでは、コラボレーションとドメインルールによって、アプリケーションの振舞いのプレースホルダーを記述し、ここから実行フレームワーク上で動作するコード(フレームワークの設定情報になるかもしれない)を生成するという方向で、アプリケーションの振舞いをコードに落とすことを考えています。

話のそれついでにコラボレーションに関連するモデリング上の話題を続けます。
コラボレーションの導入はコードの自動生成が重要な目的です。
コード生成を行うためには、模型的な意味で図形が配置されているだけでは情報量は不十分で、より詳細な情報を記述しなければなりません。
このような情報の一つに前回の記事で説明した「ドメインルールはTemplateMethodの骨組みのスロットに差し込む拡張部。アプリケーションの構成定義画面でパラメタの変更が可能」といったものがあります。
つまり、ドメインルールのところで、カスタマイズが可能なわけですが、コラボレーション側でもカスタマイズが必要な場合があります。
この目的に、UML標準部品である拡張点(extension point)を用いることができます。拡張点は(通常はユースケースに使うのですが)コラボレーションのインタラクションの一部を拡張するためのスロット的なポイントです。拡張点名を記述し、それに対する具体的な拡張のコラボレーションを拡張(extend)関係で記述します。
拡張点を用いて、コラボレーションイベント監視タスク起票のより詳細な情報を記述した図が以下のものです。
コラボレーションイベント監視タスク起票は、拡張点イベント監視を持っており、ここに拡張を実現するコラボレーションとしてコラボレーション注目発言拡張を指定しているので、注目発言を監視するコラボレーションとして動作する、というわけです。(補足ですが、この図の趣旨からは、注目発言ピックアップの対象がTwetterとなっているのは、DoainRule注目発言ピックアップの設定、ということになります。
この他にもコラボレーションをカスタマイズするメカニズムとしてステレオタイプ、タグ付き値を使用することができます。
UMLでカスタマイズを記述するとこの図のような形になるわけですが、これでは情報が不足ではないか、と思われるかもしれません。
実際のところ、その通りで、本当にコードの自動生成を行うということであれば、相当量の情報をタグ付き値などを使って設定しなければなりません。
つまるところ、UMLでモデルを記述する場合でも、結局のところ情報の過半数はテキスト情報として入力しなければならないわけです。そうであれば、始めからテキスト形式の言語で記述したほうがよい、というのがSimpleModelerのアプローチです。
テキスト情報から、上記の図レベルのものはプログラムで生成することが可能です。どのコラボレーションにどのような拡張点があるのか、といった情報をざっくり見るにはツールが生成した図を見れば十分であり、わざわざモデリング時に手で入力する必要はないわけです。
SimpleModelerでは、コラボレーションとドメインルールによって、アプリケーションの振舞いのプレースホルダーを記述し、ここから実行フレームワーク上で動作するコード(フレームワークの設定情報になるかもしれない)を生成するという方向で、アプリケーションの振舞いをコードに落とすことを考えています。
2011年4月13日水曜日
コラボレーション
ドメインモデルにおけるロジックの抽出、記述方式について検討しています。
前々回にドメインモデルの例として以下の図を作成しました。これは、ServiceEvent、ServiceResourceの導入がクラウド向けの工夫ですが、基本的には従来からあるドメインモデルの静的構造側面を記述しています。

前回は、ドメインオブジェクトとしてDomainRuleを導入することで、ドメインロジックをドメインモデルとして記述できるようにしました。それが以下の図です。

ドメインルールはあくまでもルールを記述するオブジェクトなので、記述するロジックも受動的なものになります。何かの処理の中で、ドメインが内包しているルール(たとえば消費税の計算)を使用するというのが、ドメインルールの基本的な使い方になります。
つまり、受動的なロジックであるルールを駆動する能動的なロジックが必要になるわけです。この能動的なロジックの記述はドメインモデルではなく、アプリケーションモデルとしてモデル化するのがSimpleModelingのアプローチです。アプリケーションモデルは、アプリケーションの利用者が目的を達成するための構造、振る舞いを記述するモデルです。アプリケーションモデルは、アプリケーションの文脈(プロダクトライン、ユースケースファミリなど)として定義されているドメインモデルを操作して、利用者の目標(目的を具体化した物)を達成していきます。SimpleModelingのモデリングアーキテクチャにおけるドメインモデルとアプリケーションモデルの位置付け、関係についてはいずれ説明したいと思います。
ここでは、アプリケーションを構成する能動的なロジックは基本的にアプリケーションモデルで定義するのが基本的な考え方として検討を進めます。
アプリケーションロジックの網羅的な抽出や詳細化はアプリケーションモデルを作成する段階で行うとしても、ドメインモデルの段階でもある程度の抽出は可能です。また、ドメインモデルの構造もアプリケーションモデルから利用可能な形に調整する必要があるので、ドメインモデルを作成する段階で代表的なアプリケーションロジックを記述しておくのは有用です。
アプリケーションロジックの抽出をこの段階で行うのはやや早い感もありますが、代表的な物を明確にしておくことは、モデルの目的を明確化することになるので、分かっている範囲で行っておくのがよさそうです。
アプリケーションロジックについては、ユースケース分析の中で網羅的に抽出し、ドメインモデルに反映していくことになります。
この目的で導入するモデル要素がコラボレーション(collaboration,協調)です。コラボレーションは、UMLの標準モデル要素でオブジェクト間のメッセージの送受信であるインタラクション(interaction)を(目標を達成する単位で)束ねたものです。(UML1とUML2でコラボレーションの定義が変わってしまったのですが、ここではUML1的な意味で使っています。)
コラボレーションイベント監視タスク起票を追加したドメインモデルは以下の図となります。ボクの使っているJudeではコラボレーションシンボルが使えないみたいなのでユースケースシンボルにステレオタイプcollaborationを記述して代用しています。(UMLのコラボレーションシンボルは破線の楕円です。)
コラボレーションタスク監視起票は、Twitterでの注目発言の発生を監視し、注目発言が発生したときに、この発言に対応するためのタスクを起票するコラボレーションです。このコラボレーションがアプリケーションロジックに落とし込まれていくことになります。
この段階でコラボレーションを記述する目的の一つは、ドメインモデルの精度を高めるという目的に加えて、自動生成の対象を抽出という目的もあります。このあたりは、ドメインルールを導入するのと同じ目的です。
つまり、コードの自動生成のプレースホルダーとしての役割、さらにフレームワークと連動できるコラボレーションは、実行可能レベルのコード生成が可能になるでしょう。
以上のようにドメインモデルを振る舞いの視点でみるとコラボレーション、ドメインルール、ドメインエンティティの3階層で構成されます。この階層をモデル要素の関係を実装レベルで考えてみると以下のようなイメージになります。
- コラボレーションはTemplateMethodパターン的な処理部。
- ドメインルールはTemplateMethodの骨組みのスロットに差し込む拡張部。アプリケーションの構成定義画面でパラメタの変更が可能。
- ドメインエンティティはデータベースに格納されるデータまたはサービスとやり取りするデータ。
2011年4月12日火曜日
ドメインルール
前回はエンティティ間の静的な関係(relationship)を定義する以下のドメインモデルを作成しました。モデル駆動開発によるコードの自動生成でも、この範囲の自動生成はすでに実用化または実用化の射程距離内です。
ドメインモデルの重要な軸は(このモデルが典型的な例ですが)問題領域の静的な構造の記述です。従来のアプローチは、データベースに格納するデータとデータ間の構造が中心でしたが、ServiceEventやServiceResourceの導入によって、クラウド上のイベントやリソースもスコープ内に取り込もうというのがここまでの試みです。
クラウドアプリケーションのニーズに対応した形で自動生成の対象範囲が広がりますが、データの範囲をスコープにしているという意味では従来路線を踏襲した漸進的なアプローチともいえます。もう一段、コードの生成範囲を広げられないでしょうか。
モデル駆動開発の問題点の一つは、オブジェクトモデルとしてロジックを宣言的、形式的に記述する方法が確立されていない点です。UMLできちんと記述できるのは状態機械図まで。シーケンス図/コミュニケーション図(旧コラボレーション図)は一応演繹的にも記述できることになっていますが、実用上はインタラクションのインスタンスを具体例として記述するものと考えた方がよさそうです。OCL(Object Constraint Language)は有用ですが、文字通り制約を記述するための言語なので適用範囲が限られます。MDA(Model Driven Architecture)の基盤となるxUML(Executable UML)はこの部分をAction Language (MDA的にはAction Semanticsとその実現言語)で補完していますが、Action Languageは状態機械との連動がオブジェクト指向的には進化であるとはいえ(大多数のオブジェクト指向型言語がそうであるように)手続き型折衷オブジェクト指向プログラミング言語みたいなものであり、現時点の技術では手続き型プログラミング言語を導入しないとロジック記述の問題は解決しないと考えてよさそうです。(いずれこの部分を関数型言語や論理型言語が埋めていくことになるでしょうが、まだまだ先の話です。)
どちみちプログラミング言語的な記述が必要なのであれば、ActionLanguageを使うより、使い慣れているScalaやJava(その他お好みの言語)でロジックは書きたいところです。
そこで、コードの自動生成の対象範囲を広げるための仕掛けとしてSimpleModelingが用意しているドメインモデルのモデル要素がドメインルール(ステレオタイプDomainRule)です。ドメインルールは、ドメインに存在するロジック、責務の中でルールとして扱うと適切なものをオブジェクト化したものです。ドメインルールは以前から導入済みですが、クラウド時代でも引き続き有効なドメインオブジェクトです。
ドメインモデルの中でロジックを記述する方法としては、エンティティオブジェクトのオペレーションとして定義する方法もあります。ドメインルールとはケースバイケースで使い分けることになります。
オペレーションとドメインルールの選択は以下の項目を目安にするとよいでしょう。
以下の3つのドメインルールを追加しています。
この例では、ドメインルールからドメインイベントやドメインリソースに対する使用(use dependency)を行っていますが、逆にドメインイベントやドメインリソースからドメインルールへの使用(use dependency)もありえます。例えば、消費税計算ルールを請求書発行イベントから使用するといったケースです。
ドメインルールは、ドメインモデルの中でルールを特定するプレースホルダーの役割を担います。前述したようにUMLではロジックを記述できないので、ドメインモデルでできることはここまでという割り切りです。
ただし、ステレオタイプやタグ付き値、関連端(association end)といった修飾パラメタによって生成するコードを特定することができる可能性があります。
たとえば、DomainRuleタスク生成はfactoryというステレオタイプが付いていますが、適切なパラメタを与えればファクトリオブジェクトの実装に落とし込むことは技術的に可能でしょう。
実行プラットフォーム上で動作するフレームワークによって、相当な種類のドメインルールに対応する機能の受け口を実現できるはずです。このようにプラットフォームで対応済みのルールをドメインモデル上で使用することで、ドメインモデルからコード生成できる範囲が格段に広がるでしょう。
また、自動生成には至らなかった場合でも、ロジックのプレースフォルダーとしての存在意義は十分にあります。少なくても、アプリケーションに組み込むためのSPI(Service Provider Interface)といったものの自動生成は可能で、これだけでもずいぶん違うはずです。
ボクが開発しているDSLコンパイラSimpleModelerとマッシュアップフレームワークg3では、このような連携ができることを目指しています。
ドメインモデルの重要な軸は(このモデルが典型的な例ですが)問題領域の静的な構造の記述です。従来のアプローチは、データベースに格納するデータとデータ間の構造が中心でしたが、ServiceEventやServiceResourceの導入によって、クラウド上のイベントやリソースもスコープ内に取り込もうというのがここまでの試みです。
クラウドアプリケーションのニーズに対応した形で自動生成の対象範囲が広がりますが、データの範囲をスコープにしているという意味では従来路線を踏襲した漸進的なアプローチともいえます。もう一段、コードの生成範囲を広げられないでしょうか。
モデル駆動開発の問題点の一つは、オブジェクトモデルとしてロジックを宣言的、形式的に記述する方法が確立されていない点です。UMLできちんと記述できるのは状態機械図まで。シーケンス図/コミュニケーション図(旧コラボレーション図)は一応演繹的にも記述できることになっていますが、実用上はインタラクションのインスタンスを具体例として記述するものと考えた方がよさそうです。OCL(Object Constraint Language)は有用ですが、文字通り制約を記述するための言語なので適用範囲が限られます。MDA(Model Driven Architecture)の基盤となるxUML(Executable UML)はこの部分をAction Language (MDA的にはAction Semanticsとその実現言語)で補完していますが、Action Languageは状態機械との連動がオブジェクト指向的には進化であるとはいえ(大多数のオブジェクト指向型言語がそうであるように)手続き型折衷オブジェクト指向プログラミング言語みたいなものであり、現時点の技術では手続き型プログラミング言語を導入しないとロジック記述の問題は解決しないと考えてよさそうです。(いずれこの部分を関数型言語や論理型言語が埋めていくことになるでしょうが、まだまだ先の話です。)
どちみちプログラミング言語的な記述が必要なのであれば、ActionLanguageを使うより、使い慣れているScalaやJava(その他お好みの言語)でロジックは書きたいところです。
そこで、コードの自動生成の対象範囲を広げるための仕掛けとしてSimpleModelingが用意しているドメインモデルのモデル要素がドメインルール(ステレオタイプDomainRule)です。ドメインルールは、ドメインに存在するロジック、責務の中でルールとして扱うと適切なものをオブジェクト化したものです。ドメインルールは以前から導入済みですが、クラウド時代でも引き続き有効なドメインオブジェクトです。
ドメインモデルの中でロジックを記述する方法としては、エンティティオブジェクトのオペレーションとして定義する方法もあります。ドメインルールとはケースバイケースで使い分けることになります。
オペレーションとドメインルールの選択は以下の項目を目安にするとよいでしょう。
- アプリケーションのカスタマイズ項目になりそうなものはドメインルール。
- 複数のドメインオブジェクトを横断的に操作するものはドメインルール。
以下の3つのドメインルールを追加しています。
- 注目発言ピックアップ
- Twitterからツイートを検出するルール
- タスク生成
- タスクを生成するルール
- 対応選択
- Twitterのツイートから対応を選択するルール
この例では、ドメインルールからドメインイベントやドメインリソースに対する使用(use dependency)を行っていますが、逆にドメインイベントやドメインリソースからドメインルールへの使用(use dependency)もありえます。例えば、消費税計算ルールを請求書発行イベントから使用するといったケースです。
ドメインルールは、ドメインモデルの中でルールを特定するプレースホルダーの役割を担います。前述したようにUMLではロジックを記述できないので、ドメインモデルでできることはここまでという割り切りです。
ただし、ステレオタイプやタグ付き値、関連端(association end)といった修飾パラメタによって生成するコードを特定することができる可能性があります。
たとえば、DomainRuleタスク生成はfactoryというステレオタイプが付いていますが、適切なパラメタを与えればファクトリオブジェクトの実装に落とし込むことは技術的に可能でしょう。
実行プラットフォーム上で動作するフレームワークによって、相当な種類のドメインルールに対応する機能の受け口を実現できるはずです。このようにプラットフォームで対応済みのルールをドメインモデル上で使用することで、ドメインモデルからコード生成できる範囲が格段に広がるでしょう。
また、自動生成には至らなかった場合でも、ロジックのプレースフォルダーとしての存在意義は十分にあります。少なくても、アプリケーションに組み込むためのSPI(Service Provider Interface)といったものの自動生成は可能で、これだけでもずいぶん違うはずです。
ボクが開発しているDSLコンパイラSimpleModelerとマッシュアップフレームワークg3では、このような連携ができることを目指しています。
2011年4月11日月曜日
ドメインモデルを具体的に考えてみる
ドメインモデルとデータストアのマッピングについて検討を始めたところで、話がだいぶそれてきましたが、もう少しそれてみたいと思います。
DomainResourceとServiceResourceを導入したので、試しにDomainResourceとServiceResourceが混在するドメインモデルについて具体的に考えてみました。
以下の図はTwitterのタイムラインを監視して、何らかの基準に沿ったツイートを検出し、何かの対応をすることを管理するタスクを起票するアプリケーションのドメインモデルです。タスクはNozbeのタスクとBacklogの課題として2つのサービスに同時に作成します。

こういったNozbeのタスクやBacklogの課題といった「概念」上は抽象の中に隠蔽されるオブジェクトをPIM段階のドメインモデルでどう扱うのか、というのが論点の一つ、というのがここまでの話でした。DomainResourceとServiceResourceを導入したメタモデルでは、抽象「概念」として隠蔽したいケース、具象「概念」として明示したいケースの両方に対応できるというのがミソです。
この図は具象概念として明示したいケースになります。
ドメインモデルでタスクとして扱うものは、実際には主にNozbeとBacklog上で利用者からの操作を行うことを想定しています。しかし、NozbeとBacklog間の同期やアプリケーション側での操作の目的で、自前のデータベースで管理するオブジェクトも必要になります。このオブジェクトがDomainResourceタスクです。そして、タスクからNozbeTaskとBacklog課題を集約(aggregation)します。
一方、アプリケーションが扱うイベントとしてDomainEventタスク起票とServiceEventTweet発生を定義しています。よりモデルの汎用化を進めるならServiceEventTweet発生に対応するDomainEventTweet発生を定義して抽象化しておくというアプローチも考えられます。
ドメインモデルの記述対象のスコープにも色々な切り口がありますが、一般的なのはデータベースに格納するデータの範囲です。この図の場合、DomainEventタスク起票, DomainResourceタスクがこれに当たります。
モデル駆動開発によるコードの自動生成でも、データベースに格納するオブジェクトの範囲の自動生成はすでに実用化されており、安定状態にある技術です。つまり、DomainEventタスク起票, DomainResourceタスクは自動生成のスコープ内に入ってきます。
しかし、ドメインモデルの記述がこの範囲であれば、自動生成の対象範囲もここまでということになります。
ServiceResourceやServiceEventといった外部サービスが提供するドメインオブジェクトを導入する目的は、もちろんドメインモデルの精度を上げることもありますが、実利的にはサービスが生成するイベントやリソースに対応するコードの自動生成を行える可能性が出てくることが大きいでしょう。
ServiceResourceやServiceEventをドメインモデル上で扱うことによって、twitterのストリームを監視したり、RESTで各種サービスのリソースに対してアクセスをしたりといったコードを生成することは技術的には十分射程範囲です。こういった、アプリケーションの部品として何回も何回も繰り返し作り続けられている処理を定型化して、自動生成の対象にできることが、モデリングという要求と実装の中間に位置する作業を行う具体的な価値であり、大きな動機です。このスコープを広げるために、ドメインモデルのメタモデルの拡張と、メタモデルと実装とのマッピングを進めていくことが重要となってきます。
登録:
投稿 (Atom)

 投稿