8月27,28日にクラウド温泉@小樽が開催されました。今回のクラウド温泉も盛りだくさんの内容で、ボクとしてはF#について詳しいお話を聞けたのが収穫でした。発表者の@bleisさん、MSの荒井さん、参加者の皆様、どうもありがとうございました。
F#はScalaと同じオブジェクト指向と関数型のハイブリッド言語で、ざっくりとはだいたい同じことができると捉えてみてよさそうです。ただし、言語の狙いは異なるので、利用シーンは違ってきます。
以下、F#の知識は当日の聞きかじりを元にしているので、不正確なところが多いと思いますが、ボクの現時点での認識のメモということでご了承ください。
F#の言語のセマンティクスは関数型が主でオブジェクト指向は従のようです。
関数型の世界で扱うデータはレコード/タプルで、構造体的な言語要素となっています。そして、このレコードとは別にクラス/オブジェクトが用意されています。(変数に関数をバインドしてメソッド的に使えるかもしれませんが、この点は未確認。)
つまりデータを記述する言語要素が二系統あって、そのうちの一系統を使うと関数型言語らしいプログラミングが堪能できるということですね。
一方、クラス/オブジェクトは、当日確認しなかったのですが、恐らく.NETのクラス/オブジェクトだろうと思います。クラス/オブジェクトを通じて.NETのクラス/オブジェクトをC#やVBと相互に連携できるのではないかと推測します。
データを記述する言語要素が二系統あるのは、関数型言語としての純粋性を保ちたかったということもあるでしょうし、.NETのクラス/オブジェクトを関数型言語向けに拡張するのが難しかった、という制約に起因するところもありそうです。
また、データは基本的にイミュータブルで、mutableというキーワードを付けるとミュータブルにもできるというアプローチになっています。この点からも関数型の方に軸足があることが分かります。このため、状態の存在を前提としたプログラミングには、あまり向いておらず、つまるところオブジェクト指向プログラミング言語としてはあまり快適ではなさそうです。
F#では、型パラメータの省略ができて簡潔な記述が可能になっていますが、関数をオブジェクトのメソッドとしてポリモーフィックに動かすことをやめることにより(クラス/オブジェクトではなくレコード/タプルを使う効果)、共変/反変まわりの指定を考えなくてもよいので、そのあたりが寄与しているのかなと感じました。これも、関数型側に軸足を持っている効果です。
以上のようにF#は関数型側に大きく機能を倒して、オブジェクト指向的にはほどほどにして、関数型言語の美点を伸ばしていくアプローチのようです。
このアプローチの延長線上で、コンピューテーション式、seq/yieldといったところが、関数型言語の高度な応用で、マニア的に面白いところですね。どちらもDSLの記述力を高めることに大きく寄与する機能です。
F#は関数型言語として素晴らしい言語であるのは確かですが、関数型側に機能を倒しているため、オブジェクト指向言語としては快適というわけではなく、実務へ適用する汎用言語としては考えにくいのかなという印象を持ちました。F#一本ですべての応用を記述する、ということにはならないかなと。
そこで、F#を取り囲む文脈を考えてみましょう。F#は.NET上で動作することを前提とした言語であり、C#やC++といった.NETの他の言語と共存することが前提です。
C#の場合は、VBなどを置き換えていって、.NETの中心言語にしていくという意図もあったかと思いますが、F#の場合は、C#を置き換えるといったことは意図しておらず、C#を補完する立場になるでしょう。そうすると、C#ができることを全部カバーした上で、新たに関数型の機能を追加するといったことをする必要はなく、オブジェクト指向的な文法は.NETのクラス/オブジェクトと連携できるものがあれば十分と割り切ることができます。その上で、C#ではできない関数型のプログラミングモデルを使いやすいものにする方向に力をそそいでいるわけですね。
そういう意味で、F#は.NETワールドを構成するパーツの一つとして、並列プログラミングやDSLといった関数型に適した分野をカバーする専用言語という戦略上の意図を持った言語であると推測されます。
今後の技術の発展の方向は並列プログラミングとDSLが二大潮流になることは確実なので、この2つの分野に強い関数型言語を並行プログラミングとDSL向けを意識してチューニングし、.NETワールド内でのポジションを明確にした上で提供してきているのにはMicrosoftの底力を感じました。
F#は、monoと組合わせてMacやLinuxでも普通に動くみたいなので、DSLにフォーカスした応用ではプラットフォームを問わず実用的に使用できそうです。そういう意味でも面白い存在です。
2011年8月31日水曜日

2011年7月19日火曜日
SimpleModeler (クラウド温泉@小樽)
クラウド温泉@小樽では、モデルコンパイラSimpleModelerからg3フレームワーク上で動作するクラウドサービス、g4フレームワーク上で動作するAndroidクライアントを自動生成し、Androidクライアントとクラウドサービスが連携動作するデモを行う予定です。

まずScala DSLでモデルを記述します。(デモではより効果を狙ってCSVでモデル記述するかもしれません。)
このScala DSLからSimpleModelerを使って、Android用クライアントとGoogle App Engine/Tomcat(Glassfish)の両方で動作するRESTサービスを生成します。
生成された、AndroidクライアントとRESTサービスは連携して、データに対するCRUD処理を行うことができます。
Android用クライアントはg4フレームワーク上で動作します。g4フレームワークはGoogle GuiceによるDIをベースにしたAndroidアプリケーションフレームワークです。
サーバープログラムはg3フレームワーク上で動作します。g3フレームワークはGoogle App Engineと、TomcatやGlassfishなどの通常のServletコンテナ上で動作します。ServletコンテナはEC2を始め、一般的なクラウドプラットフォーム上で動作します。このため、g3フレームワークを用いることでクラウドプラットフォーム上で可搬性のあるアプリケーションを作成することができます。
デモの目的
デモでは、見栄えや分りやすさの点からプログラミングレスで自動生成したアプリケーションがそのまま動作することを主眼とします。
しかし、このデモはモデル駆動開発でアプリケーションプログラムが自動生成されるということを主張するのが趣旨ではありません。現在の所、CRUDのような特定の定形処理以外はアプリケーションの自動生成は、まだまだ実用化には程遠いからです。
それでは、SimpleModelerによるプログラムの自動生成は何をコンセプトとしているのでしょう。
それは、ひとことで言うと「ドメインライブラリの自動コーディング」です。
ドメインモデル
オブジェクトモデリングでは大きく分析モデル(またはPIM, Platform Indenpendent Model)と設計モデル(またはPSM, Platform Specific Model)の2つのモデルを作成します。これはモデルの抽象度が分類の軸になっています。
分析モデルに対して、動作ターゲットのプラットフォームと非機能要求を加えて、実際に動作するプログラムの設計図となる設計モデルとなります。
モデルの分類の軸は他にも色々ありますが、筆者が有効と考えているものにアプリケーションモデルとドメインモデルの軸があります。
ドメインモデルは、アプリケーションの問題領域の構造をモデル化したものです。主に静的モデルにフォーカスしたモデルで、静的構造中心、モデルのライフサイクルが長い、自動生成の対象になりやすいという特性があります。
一方、アプリケーションモデルはドメインモデルを使用して、アプリケーション利用者の目的を達成するための仕組みをモデル化したものです。主に動的モデルにフォーカスしたモデルで、アプリケーションモデルは、振舞い中心、モデルのライフサイクルが短い、自動生成の対象になりにくいという特性があります。

ドメインモデルは、静的構造(クラス図)中心となりますが、動的モデルとして状態機械、ルールモデル、アクション言語を併用します。(アプリケーションモデルでは、ユースケース、インタラクション、コラボレーションなどを使用します。)
静的構造図が中心のモデルの場合、オブジェクト指向言語を使うと設計モデルとプログラムのセマンティクスギャップが非常に少ないので、設計モデルを飛ばして直接プログラミングすることも可能です。短期開発では、その方が効率もよく、プログラムの品質もよくなるでしょう。また、持続性を重視する製品開発でも、静的構造のみでよければER図などのデータモデリングで十分です。
一方、状態機械やルールモデルなど、プログラミング言語とのセマンティクスギャップが大きいモデルを使用する場合は短期開発であっても引き続き設計モデルが有効です。
ドメインライブラリ
現状では、ドメインモデルを作成しても手作業でプログラミングすることが多く、モデルを作成しても作業量は減りません。プログラミング側での改修がモデルに反映されなくなり、長期的にはモデルが死んでしまうという問題もあります。
ドメインモデルからRDBMSのDDLや、O/Rマッパーのコード生成などを行うツールはあるので、データモデリングの範囲では自動生成を取り込んだ運用を行うことは可能です。
しかし、動的モデルを包含したオブジェクトモデル全体のスコープでは、ドメインモデルに限定しても、プログラムの自動生成はまだまだ発展途上といえるでしょう。
しかし、ドメインモデルを実用的に記述できる範囲でドメインモデルのプロファイルを定めておくことは可能です。筆者はこの目的でドメインモデル(とアプリケーションモデル)のプロファイルをまとめています。詳しくはこちらをどうぞ。(『上流工程UMLモデリング』、『マインドマップではじめるモデリング講座』)
ドメインモデルの重要な特性の一つは、自動生成に適しているということです。決められたパーツを使ってドメインモデルを記述するという運用にすれば、分析モデルから、設計モデルをバイパスしてほぼ完全に実装を自動生成することができます。また設計モデルも仕様書という形で生成可能です。もちろん、100%完全は難しいでしょうが、適切な拡張ポイントを生成することで、部分的なプログラミングで補完可能にできるでしょう。
SimpleModelerは、この実現を目指しています。
ドメインライブラリとアプリケーションフレームワーク
ドメインライブラリを単体で生成するのも十分に有効ですが、適切なアプリケーションフレームワークがあれば、この枠組みの中に組み込んでしまえば、アプリケーション開発をより効率的に行うことができます。
アプリケーションフレームワークの上にドメインライブラリをビルトインしたものを土台にしてアプリケーション開発を進めることができます。
 クラウドアプリケーション向けにg3フレームワーク、Androidアプリケーション向けにg4フレームワークを開発したので、これらのフレームワーク上にビルトインできるドメインライブラリを生成します。
自動コーディング
モデル駆動開発について以下のような疑問をしばしば耳にします。
しかし、ドメインモデルに範囲を限定すれば、相当量のコードの自動生成が可能なので、これをまったく無視するのはあまりにももったいない。
そこで、コンパイラモデルに代わって、プログラムの自動生成をソフトウェア開発の枠組に取り込む切り口として考えているのが『クラスライブラリの「自動コーディング」』というコンセプトです。
言うまでもなくソフトウェア開発では、多数のクラスライブラリを併用して開発を進めるのが普通です。多くのクラスライブラリはオープンソースであり、APIリファレンスとソースコードの両方を参照して利用できます。
基本的にはAPI仕様をみて使いますが、詳細仕様を知りたい時にはソースコードも参照します。デバッグ時にはクラスライブラリのソースも取り込んでブレークポイントを張ったり、変数の値を確認したりします。
クラスライブラリのバグ修正は追加は、短期対応と長期対応の2つのフェーズで行われます。まず、短期対応として、必要に応じてパッチを当てたりして修正します。
その後、バグの修正や機能追加は所定の手続きをへてクラスライブラリに反映されます。長期対応として、この修正が取り込まれた新しいバージョンのクラスライブラリを、改めてアプリケーションに取り込みます。
ここで、発想を少し変えてみましょう。
事前に誰かが用意したクラスライブラリでも、プログラムが自動生成したクラスライブラリでも、利用者からは全く同じです。
つまり、クラスライブラリとしてとして運用するのであれば、プログラムの自動生成を用いても、今までの開発と何ら変わるところはないはずです。
次は、ニーズの面から考えてみましょう。
プログラミングをするときに、特定のドメイン向けのクラスライブラリが整備されているととても効率的です。
しかし、特定のドメイン向けのドメインクラスライブラリは、よほど共通して使用される大きなドメインでないと事前に誰かが用意しているということはありません。
このため、ソフトウェア開発の初期段階では、ドメインモデルをコードとして実装する作業を黙々と続けることになります。あるいは、画面とデータベースをつなぐ処理として、画面のイベントハンドラーの中にドメイン処理が重複して繰り返し生産されることになります。
前者では、ドメインモデルのコーディングが開発全体のボトルネックになりますし、後者では、アプリケーションの保守性、拡張性に問題が出てきます。
この問題を、ドメインクラスライブラリの自動コーディングが解決することができます。前述したようにドメインモデルはほぼ完全な自動生成が可能なので、ドメインライブラリを自動生成するのは実用範囲です。そこで、ドメインモデルをドメインクラスライブラリとして"自動コーディング"してしまおう、というわけです。
出来合いの標準品ではなく、自分向けのクラスライブラリですから、アプリケーションのニーズにもぴったり合います。使い方は、ソースコードが提供されている通常のクラスライブラリと全く同じです。
また、クラウドアプリケーション、スマートデバイスによって、ドメインモデリングの技術にも色々な影響があることが予想されます。このあたりも面白い議論ができそうです。

まずScala DSLでモデルを記述します。(デモではより効果を狙ってCSVでモデル記述するかもしれません。)
このScala DSLからSimpleModelerを使って、Android用クライアントとGoogle App Engine/Tomcat(Glassfish)の両方で動作するRESTサービスを生成します。
生成された、AndroidクライアントとRESTサービスは連携して、データに対するCRUD処理を行うことができます。
Android用クライアントはg4フレームワーク上で動作します。g4フレームワークはGoogle GuiceによるDIをベースにしたAndroidアプリケーションフレームワークです。
サーバープログラムはg3フレームワーク上で動作します。g3フレームワークはGoogle App Engineと、TomcatやGlassfishなどの通常のServletコンテナ上で動作します。ServletコンテナはEC2を始め、一般的なクラウドプラットフォーム上で動作します。このため、g3フレームワークを用いることでクラウドプラットフォーム上で可搬性のあるアプリケーションを作成することができます。
デモの目的
デモでは、見栄えや分りやすさの点からプログラミングレスで自動生成したアプリケーションがそのまま動作することを主眼とします。しかし、このデモはモデル駆動開発でアプリケーションプログラムが自動生成されるということを主張するのが趣旨ではありません。現在の所、CRUDのような特定の定形処理以外はアプリケーションの自動生成は、まだまだ実用化には程遠いからです。
それでは、SimpleModelerによるプログラムの自動生成は何をコンセプトとしているのでしょう。
それは、ひとことで言うと「ドメインライブラリの自動コーディング」です。
ドメインモデル
オブジェクトモデリングでは大きく分析モデル(またはPIM, Platform Indenpendent Model)と設計モデル(またはPSM, Platform Specific Model)の2つのモデルを作成します。これはモデルの抽象度が分類の軸になっています。分析モデルに対して、動作ターゲットのプラットフォームと非機能要求を加えて、実際に動作するプログラムの設計図となる設計モデルとなります。
モデルの分類の軸は他にも色々ありますが、筆者が有効と考えているものにアプリケーションモデルとドメインモデルの軸があります。
ドメインモデルは、アプリケーションの問題領域の構造をモデル化したものです。主に静的モデルにフォーカスしたモデルで、静的構造中心、モデルのライフサイクルが長い、自動生成の対象になりやすいという特性があります。
一方、アプリケーションモデルはドメインモデルを使用して、アプリケーション利用者の目的を達成するための仕組みをモデル化したものです。主に動的モデルにフォーカスしたモデルで、アプリケーションモデルは、振舞い中心、モデルのライフサイクルが短い、自動生成の対象になりにくいという特性があります。

ドメインモデルは、静的構造(クラス図)中心となりますが、動的モデルとして状態機械、ルールモデル、アクション言語を併用します。(アプリケーションモデルでは、ユースケース、インタラクション、コラボレーションなどを使用します。)
静的構造図が中心のモデルの場合、オブジェクト指向言語を使うと設計モデルとプログラムのセマンティクスギャップが非常に少ないので、設計モデルを飛ばして直接プログラミングすることも可能です。短期開発では、その方が効率もよく、プログラムの品質もよくなるでしょう。また、持続性を重視する製品開発でも、静的構造のみでよければER図などのデータモデリングで十分です。
一方、状態機械やルールモデルなど、プログラミング言語とのセマンティクスギャップが大きいモデルを使用する場合は短期開発であっても引き続き設計モデルが有効です。
ドメインライブラリ
現状では、ドメインモデルを作成しても手作業でプログラミングすることが多く、モデルを作成しても作業量は減りません。プログラミング側での改修がモデルに反映されなくなり、長期的にはモデルが死んでしまうという問題もあります。ドメインモデルからRDBMSのDDLや、O/Rマッパーのコード生成などを行うツールはあるので、データモデリングの範囲では自動生成を取り込んだ運用を行うことは可能です。
しかし、動的モデルを包含したオブジェクトモデル全体のスコープでは、ドメインモデルに限定しても、プログラムの自動生成はまだまだ発展途上といえるでしょう。
しかし、ドメインモデルを実用的に記述できる範囲でドメインモデルのプロファイルを定めておくことは可能です。筆者はこの目的でドメインモデル(とアプリケーションモデル)のプロファイルをまとめています。詳しくはこちらをどうぞ。(『上流工程UMLモデリング』、『マインドマップではじめるモデリング講座』)
ドメインモデルの重要な特性の一つは、自動生成に適しているということです。決められたパーツを使ってドメインモデルを記述するという運用にすれば、分析モデルから、設計モデルをバイパスしてほぼ完全に実装を自動生成することができます。また設計モデルも仕様書という形で生成可能です。もちろん、100%完全は難しいでしょうが、適切な拡張ポイントを生成することで、部分的なプログラミングで補完可能にできるでしょう。
SimpleModelerは、この実現を目指しています。
ドメインライブラリとアプリケーションフレームワーク
ドメインライブラリを単体で生成するのも十分に有効ですが、適切なアプリケーションフレームワークがあれば、この枠組みの中に組み込んでしまえば、アプリケーション開発をより効率的に行うことができます。アプリケーションフレームワークの上にドメインライブラリをビルトインしたものを土台にしてアプリケーション開発を進めることができます。

自動コーディング
モデル駆動開発について以下のような疑問をしばしば耳にします。- モデルからプログラム全体を生成するのは無理ではないか。
- モデルから自動生成したプログラムを直接修正した時に、モデルに反映できないと、以降の開発にモデルを使うことができない。
- モデルレベルでデバッグできないとバグ修正ができない。
しかし、ドメインモデルに範囲を限定すれば、相当量のコードの自動生成が可能なので、これをまったく無視するのはあまりにももったいない。
そこで、コンパイラモデルに代わって、プログラムの自動生成をソフトウェア開発の枠組に取り込む切り口として考えているのが『クラスライブラリの「自動コーディング」』というコンセプトです。
言うまでもなくソフトウェア開発では、多数のクラスライブラリを併用して開発を進めるのが普通です。多くのクラスライブラリはオープンソースであり、APIリファレンスとソースコードの両方を参照して利用できます。
基本的にはAPI仕様をみて使いますが、詳細仕様を知りたい時にはソースコードも参照します。デバッグ時にはクラスライブラリのソースも取り込んでブレークポイントを張ったり、変数の値を確認したりします。
クラスライブラリのバグ修正は追加は、短期対応と長期対応の2つのフェーズで行われます。まず、短期対応として、必要に応じてパッチを当てたりして修正します。
その後、バグの修正や機能追加は所定の手続きをへてクラスライブラリに反映されます。長期対応として、この修正が取り込まれた新しいバージョンのクラスライブラリを、改めてアプリケーションに取り込みます。
ここで、発想を少し変えてみましょう。
事前に誰かが用意したクラスライブラリでも、プログラムが自動生成したクラスライブラリでも、利用者からは全く同じです。
つまり、クラスライブラリとしてとして運用するのであれば、プログラムの自動生成を用いても、今までの開発と何ら変わるところはないはずです。
次は、ニーズの面から考えてみましょう。
プログラミングをするときに、特定のドメイン向けのクラスライブラリが整備されているととても効率的です。
しかし、特定のドメイン向けのドメインクラスライブラリは、よほど共通して使用される大きなドメインでないと事前に誰かが用意しているということはありません。
このため、ソフトウェア開発の初期段階では、ドメインモデルをコードとして実装する作業を黙々と続けることになります。あるいは、画面とデータベースをつなぐ処理として、画面のイベントハンドラーの中にドメイン処理が重複して繰り返し生産されることになります。
前者では、ドメインモデルのコーディングが開発全体のボトルネックになりますし、後者では、アプリケーションの保守性、拡張性に問題が出てきます。
この問題を、ドメインクラスライブラリの自動コーディングが解決することができます。前述したようにドメインモデルはほぼ完全な自動生成が可能なので、ドメインライブラリを自動生成するのは実用範囲です。そこで、ドメインモデルをドメインクラスライブラリとして"自動コーディング"してしまおう、というわけです。
出来合いの標準品ではなく、自分向けのクラスライブラリですから、アプリケーションのニーズにもぴったり合います。使い方は、ソースコードが提供されている通常のクラスライブラリと全く同じです。
クラウド温泉@小樽
SimpleModelerのコンセプトが「ドメインライブラリの自動コーディング」であることを説明しました。クラウド温泉@小樽では、SimpleModelerのデモをネタに、ドメインライブラリの自動コーディングというコンセプト、実現性、応用について議論できればと思っています。また、クラウドアプリケーション、スマートデバイスによって、ドメインモデリングの技術にも色々な影響があることが予想されます。このあたりも面白い議論ができそうです。
2011年7月11日月曜日
g4 (クラウド温泉@小樽)
クラウド温泉@小樽では、Androidアプリケーションの自動生成のデモをしますが、その基盤となるAndroidアプリケーションフレームワークであるg4について説明します。
g4はSImpleModelerによるAndroidアプリケーション自動生成の基盤として新規作成したアプリケーションフレームワークです。
g4の基本構成は以下の通りです。

ボクのAndroid開発経験から、Androidのアプリケーションアーキテクチャとして、この図に示したものがよいのではないかという仮説のものと、このアーキテクチャの基盤となるクラス群を提供してます。
アーキテクチャの基盤となるクラスは以下の3つに分類できます。
Service, Intent, ContentProviderは、ソースコードの自動生成の直接の対象です。特にドメインモデルからIntentとContentProviderはほぼ完全な形で自動生成できる見込みです。
Serviceは、ファサード部分を自動生成して、実現部分をコーディングする形になりますが、これに対応した拡張を行う予定です。
Guiceを使ったDIで、アプリケーションを構築する各オブジェクトの結合度を低くし、オブジェクトの再利用性、拡張性、保守性、テスタビリティを高めます。
このGuiceのモジュールを定義するクラスがModuleです。g4ではGuiceのMiduleをg4用に拡張した基底クラスを提供しています。
この方法は初期実装は楽ですが、プログラムがある程度大きくなってくると、再利用性、拡張性、保守性、テスタビリティが損なわれることになります。
そこで、持続的に機能拡張を続ける本格的なアプリケーションの場合はきちんとしたアプリケーションアーキテクチャの構成を取るのが得策です。アプリケーションアーキテクチャでは、分散対象となる部品の構成、分散配置の戦略を定めます。そしてユースケースを構成する各種責務を色々なオブジェクトに分散配置していくことになります。
g4では、以下の方針で責務の分散配置を行います。
Androidの基本ライブラリのみだと、ここで述べたアプリケーションアーキテクチャを実装することが難しいので、必要なオブジェクトをg4独自クラスとして追加しているわけです。
g4はSImpleModelerによるAndroidアプリケーション自動生成の基盤として新規作成したアプリケーションフレームワークです。
g4の基本構成は以下の通りです。

ボクのAndroid開発経験から、Androidのアプリケーションアーキテクチャとして、この図に示したものがよいのではないかという仮説のものと、このアーキテクチャの基盤となるクラス群を提供してます。
アーキテクチャの基盤となるクラスは以下の3つに分類できます。
- Android基本ライブラリを拡張
- Google Guideを拡張
- g4独自クラス
Android基本ライブラリ
Android基本ライブラリが提供するクラスです。これらのクラスをさらに拡張した基底クラスを用意しています。
Application
- アプリケーション
Activity
- Android画面
Fragment
- Android画面の断片(Android 3.0以降)
View
- Android画面の部品
Service
- アプリケーション本体を補完するサービス
Intent
- Activity/Service間で流通する情報
ContentProvider
- 情報提供
Service, Intent, ContentProviderは、ソースコードの自動生成の直接の対象です。特にドメインモデルからIntentとContentProviderはほぼ完全な形で自動生成できる見込みです。
Serviceは、ファサード部分を自動生成して、実現部分をコーディングする形になりますが、これに対応した拡張を行う予定です。
Google Guiceを拡張
g4は、DI(Dependency Injection)を用いたアプリケーション組立てをサポートします。DI機能にはGoogle Guice(without AOP)を用いています。Guiceを使ったDIで、アプリケーションを構築する各オブジェクトの結合度を低くし、オブジェクトの再利用性、拡張性、保守性、テスタビリティを高めます。
このGuiceのモジュールを定義するクラスがModuleです。g4ではGuiceのMiduleをg4用に拡張した基底クラスを提供しています。
Module
- Google Guiceのモジュール定義クラス
g4クラス
g4では以下のAndroidが提供する基本クラスに、以下のクラスを追加してAndroidアプリケーションのアプリケーションアーキテクチャを構築しています。
Controller
- 画面が実行する責務を提供
Agent
- モデルの更新を伴う責務を実装
Model
- ドメインモデル
ErrorModel
- エラーモデル
Driver
- 外部リソースにアクセスするドライバ
Factory
- オブジェクトの生成とインジェクション
Repository
- エンティティオブジェクトの管理
この方法は初期実装は楽ですが、プログラムがある程度大きくなってくると、再利用性、拡張性、保守性、テスタビリティが損なわれることになります。
そこで、持続的に機能拡張を続ける本格的なアプリケーションの場合はきちんとしたアプリケーションアーキテクチャの構成を取るのが得策です。アプリケーションアーキテクチャでは、分散対象となる部品の構成、分散配置の戦略を定めます。そしてユースケースを構成する各種責務を色々なオブジェクトに分散配置していくことになります。
g4では、以下の方針で責務の分散配置を行います。
- 利用者視点でドメインモデルを操作する責務はControllerに配置
- ドメインモデル視点でモデルの更新処理を行う責務はAgentに配置
- ドメインモデルはModelに配置
- エラー処理の責務はErrorModelに集約
- 外部リソースへのアクセスはDriverに集約
Androidの基本ライブラリのみだと、ここで述べたアプリケーションアーキテクチャを実装することが難しいので、必要なオブジェクトをg4独自クラスとして追加しているわけです。
2011年7月9日土曜日
g3 (クラウド温泉@小樽)
8月27日(土)/28日(日)に開催されるクラウド温泉@小樽に向けて、現時点でのg3/g4/SimpleModelerの技術について整理しておこうと思います。
Scala DSLベースのモデルコンパイラSimpleModelerでは、当初Glassfish(Java EE)、Spring、Google App Engineといったクラウドプラットフォームあるいはその上で利用するフレームワークのAPI上に直接プログラムを生成することを目指していました。
実際に、Google App Engineでのプログラム生成を実装したところ、生成するプログラム側で相当な作り込みが必要となり、ある意味フレームワークそのものを生成するような形になってしまうことが分かりました。結局、共通部品として必要なものは、自動生成ではなくフレームワークとして独立して提供するのが筋ということですね。
クラウドアプリケーション向けのフレームワークとしては、既存のフレームワークを流用するのが有力な選択肢です。Java EEやSpringといったエンタープライズ向けのWebフレームワーク、あるいはMule ESBやCamelといったESBについても比較検討したのですが、ボクが必要としている機能とはまだま距離があるということで、新規に開発することにしました。
こうして開発したのがg3フレームワークです。
目標
g3を一言で表現すると『Scala DSLベースREST指向粗粒度非同期コンポーネントフレームワーク』です。
Scala DSLベースのモデルコンパイラSimpleModelerでは、当初Glassfish(Java EE)、Spring、Google App Engineといったクラウドプラットフォームあるいはその上で利用するフレームワークのAPI上に直接プログラムを生成することを目指していました。
実際に、Google App Engineでのプログラム生成を実装したところ、生成するプログラム側で相当な作り込みが必要となり、ある意味フレームワークそのものを生成するような形になってしまうことが分かりました。結局、共通部品として必要なものは、自動生成ではなくフレームワークとして独立して提供するのが筋ということですね。
クラウドアプリケーション向けのフレームワークとしては、既存のフレームワークを流用するのが有力な選択肢です。Java EEやSpringといったエンタープライズ向けのWebフレームワーク、あるいはMule ESBやCamelといったESBについても比較検討したのですが、ボクが必要としている機能とはまだま距離があるということで、新規に開発することにしました。
こうして開発したのがg3フレームワークです。
目標
g3を一言で表現すると『Scala DSLベースREST指向粗粒度非同期コンポーネントフレームワーク』です。- フレームワークのアプリケーションインタフェースにはScala DSLを用いる。
- 粗粒度のコンポーネントを非同期で連携してアプリケーションを構築する。
- コンポーネント間の連携にはRESTを用いる。
プログラミングモデルとDSL
クラウドアプリケーションのアプリケーションアーキテクチャとしてどのようなものが適切かというのはまだまだ未知の領域ですが、ボクが仮説として考えているのが並行動作する粗粒度コンポーネントをメッセージングで接続する、コンポーネントベースのアーキテクチャです。 粗粒度コンポーネント間の連携プロトコルとしてRESTセマンティクスを用いることで、プログラミングモデル上、インターネット空間とシームレスに接続することができます。Scala DSL
このアーキテクチャを取るときの論点の一つが、コンポーネントの組立てをいかに簡単に記述するのかという点です。このようなコンポーネントの組立てにXMLを用いるのが従来の手法ですが、以下の問題があります。まず、XMLによる定義は記述が煩雑になってしまうこと。また、プログラミング言語とのシームレスな連携ができないので、プログラミング言語とXMLの二本立ての管理になってしまうという問題もあります。関連して、定義ファイルにプログラミング的な技法、たとえばマクロを導入して定義の共通部をまとめることにできるようにする、いったことを実現することも困難です。 この問題を解決するために採用したのが、Scalaをホスト言語にしたDSLです。専用言語であるDSLを用いることで、メッセージングによるコンポーネントの連携を簡潔に記述することができます。 また、Scalaを通してScalaだけでなくJavaやその他JavaVM上で動作するプログラミング言語で記述されたプログラムと連携することができます。REST指向
REST指向は、Webプロトコルとのシームレスな連携、フレーム内リソース識別のURI化、コンポーネント連携に用いるメッセージをAtomフィードベースにしていることにより実現しています。イベント駆動
クラウドアプリケーションは非同期に発生するイベントを受けて動作するイベント駆動で処理する構造がアプリケーションの基本アーキテクチャになるというのがボクの仮説の一つです。 比喩的には、割り込みハンドラーとシステムアクティビティでアプリケーションを構築する組込み機器のような構造をイメージしています。 イベント駆動はまだ実現できていませんが、その前提となるメッセージの到着を起点に処理を駆動するメカニズムは実現しています。エンティティとして永続管理するビジネスイベントと、揮発性のシステムイベントをどのように再構成して、フレームワークのアーキテクチャ上に位置付けていくのか考慮中です。状態機械
イベントの発生を受けて、発生したイベントとリソースの状態の組に対して、適合するアクションを実行するというのが、オブジェクト指向の動的モデルの基本的な考えです。 イベント駆動型のアプリケーションでは、この状態機械による動的モデルの記述と実行が重要な意味を持ってくることになります。残念ながら現状のオブジェクト指向言語では、状態機械のサポートを行っていないのでプログラムで直接記述することができません。 このメカニズムをフレームワークで実現したいというのもg3の目的の一つです。 プログラミング言語でサポートされていない必須機能をフレームワークで実現するわけですが、Scala DSLによるアプリケーションインタフェースを用いるので、ある意味新しい専用言語を導入するのと同じインパクトがあります。 状態機械の記述方式と上流モデルとの連携方法について、前述のイベント駆動のメカニズム、記述方法と合わせて検討中です。スケーラビリティ
クラウドアプリケーションでは、スケーラビリティも重要な要件です。すべてのアプリケーションがフルにスケーラビリティを追求する必要はありませんが、必要に応じてスケーラビリティを確保する手段をモデリング、アプリケーションアーキテクチャ、フレームワークといった様々な層の技術の中に事前に織り込んでおく必要があります。 g3はスケーラビリティ確保の手段として非同期メッセージング、KVSのサポートを行っています。 非同期メッセージングとして前述したようにREST指向のメッセージを粗粒度コンポーネント間でパイプライン的に流通させるモデルをとっています。現在はまだ実現できていませんが、CPS(Continuous Passing Style;継続渡しスタイル)的な処理の記述や、メッセージキューを媒介にした非同期処理などを取り込める構造になっています。 また、データストアのスケーラビリティについてはKVSを包含したデータアクセス基盤を用意しました。 KVSも、Redisのように本当のKey/Value対のデータストアもありますしGoogle App Engine DataStoreのようにISAM的なデータ構造を持っているものもあります。以上の点から、KVSといってもISAMデータ構造、要するに単純な表形式のデータ構造を扱うようにしています。 クラウドアプリケーションでは、一貫性重視の用途にはRDBMS、スケーラビリティ重視の用途にはKVSを使い分けることになります。その場合、RDBMSとKVS間でデータを持ちまわる処理も普通に行われるのでKVSとRDBMSに対する統一アクセス法が欲しくなります。 また、このアクセス法はREST指向アーキテクチャ上で使用することになるので、RESTとのシームレースに連携できることが必要です。 g3では上記の要件を満たす統一アクセス法をサポートしました。REST指向アーキテクチャに沿って普通に処理を記述するだけで、特に意識することなくKVSを使用することができます。(もちろん、KVSをスケールさせるためにはキーの選定など特別な考慮が必要になりますが、疎通レベルでは簡単に使えるというのも重要です。) なお、SQLを直接使用したアクセスも可能ですし、Javaを直接使ってJDBCを使用することもできるので、必要に応じて使い分けすることもできます。各種機能
実用上有用な機能として以下の機能を実装しました。- Web Socket
- Ext-JS対応
- 各種クラウドサービス用ドライバ(Twitter, Google Calendar, Dropbox, Evernote)
スコープ外の機能
g3の提供する機能という切り口とは別に、g3がスコープ外としている機能、後回しにしている機能が分かれば、g3の目的・意図が明確になると思います。 以下の機能はフレームワークの直接のスコープ外としています。- Web MVCフレームワーク
- テンプレートエンジン
次の段階で取り組むもの
以下の機能は、次の段階で取り組む予定にしています。- DI(Dependency Injection)
- OSGi
- JMX
- Android
- TDD/BDD
2011年6月29日水曜日
クラウド温泉@小樽
正式の広報はまだですが、8月27日(土)/28日(日)にクラウド温泉@小樽が開催される予定です。温泉に浸かりながら、クラウドを肴に語り合いましょう、という企画です。
ここ数年取り組んでいた、ScalaによるDSL駆動開発について、開発していたツールが形になってきたので、クラウド温泉でお披露目する予定です。
DSL駆動開発の軸となるのがScala DSLコンパイラSimpleModelerです。当初は、SimpleModelerでモデルからクラウドプラットフォームのAPI上に対して直接クラウドアプリケーションの生成を試行していたわけですが、適切なアプリケーションフレームワークがないと自動生成もままならない、ということが分かりクラウドプラットフォーム向けにRESTメッセージングフレームワークであるg3を開発しました。
g3はAtomPubメッセージによるRESTを軸としてコンポーネントの連携動作を行うイベント駆動フレームワークです。
g3はデータストアアクセスを含めてTomcatなどのWebサーバとGoogle App Engineの両方で動作します。できるだけ同じプログラムを色々なクラウド・プラットフォームで動作させることがg3の目的の一つです。
また、クラウド時代にはUIが、伝統的なWeb UIからAjaxベースのGUIやスマートデバイスに移行することになります。このところ仕事でAndroidに取り組んでいたこともあり、Android向けのプログラム生成の基盤となるフレームワークg4を作ってみました。
Androidのアプリケーションアーキテクチャは、以前「Androidのアーキテクチャ」で考えてみましたが、これをさらに発展させプログラムの自動生成に対応したものを実装しました。
クラウド温泉のセッションでは、SimpleModelerからg3を使ったGoogle App Engineアプリケーションと、g4を使ったAndroidアプリケーションの自動生成のデモを行う予定です。自動生成したAndroidアプリケーションとGoogle App Engineはもちろん連携動作します。
といいつつ、g3アプリケーション(App Engine)とg4アプリケーション(Android)の自動生成はこれから作るので(汗)、実際にデモまで辿りつけるかは分かりませんが、クラウド温泉を励みにして取り組んでいく予定です。
2011年5月31日火曜日
データストアのアクセス特性
4月の中頃に書いていた記事の続きなんですが、ずいぶん間が空いてしまいました。そこでは、すこしモデリングの話題に寄り道しましたが、ドメインモデルとデータストアのマッピングの話題に戻りたいと思います。
ドメインモデルとデータストアのマッピングを考える上で重要なのがデータストアの分類です。データストアの分類軸として、色々なものが考えられますがその一つとして、データアクセス特性があります。
クラウドプラウドプラットフォームにおけるデータストアの性能特性と、アプリケーションのニーズの対応関係を整理し、アプリケーションの用途に合わせた性能特性を持つデータストアを選択することが重要になります。
RDBMS登場後は、データストアの選択もRDBMS一本でよかったのですが、クラウドプラットフォーム、NoSQLといった新しい技術の登場で、データストアの選択、あるいは使い分けがアーキテクチャ選択上、重要な要因になってきました。
そこで、データストア選択のための評価軸を整理しておくことにしました。現時点で思いつくのがアクセスパターン、アクセス方式、アクセスサイズです。他によいものあれば随時追加していきたいと思います。
アクセスパターン
データストアに対するアクセスパターンとして以下の分類を使用します。
- read-only
- 参照のみ。
- read-write
- 参照と更新。
- read-mostly
- ほとんど参照、まれに更新。
- write-only
- 書き込みのみ。
read-writeが一番汎用的ですが、スケーラビリティの達成が困難になります。
その他の3つのアクセスパターンは、read-writeよりもアクセスの自由度が限定される分、スケーラビリティを高くする事ができます。
read-onlyは文字通り参照のみのアクセスで、更新処理はありません。このパターンでは、データの複製を必要な数だけ用意することができるので、スケーラビリティを高めることができます。
read-mostlyは分散技術でよく用いられる呼び方で、ほとんど参照のみで、たまに更新があるという特性です。この特性と、データの一貫性は厳密に制御しないという方式を組み合わせるとキャッシュを広範囲にわたって配布、共有できるのでスケーラビリティを大幅に向上させることができます。
write-onlyはアプリケーションからは書込みのみを行うパターンです。ログなどが典型例ですが、CQRSといったアーキテクチャではデータ投入にこのアクセスパターンを用います。
read-writeでは、データの一貫性を保つための制御に大きなオーバヘッドあり、write-onlyとすることでこのオーバヘッドを避けることができます。
アクセス方式
アクセス方式として以下の分類を使用します。
- sequential
- シーケンシャルアクセス
- random
- ランダムアクセス
sequentialは、データを先頭から最後尾まで連続でアクセスするアクセスパターンです。先頭から最後尾までの連続アクセスも、さらに索引順と格納順に分けることができますが、現在は索引を持つのが普通(あるいはカラムナDB)なので考えないことにします。
randomは、データを一部をランダムにアクセスするアクセスパターンです。
OLTPはランダムアクセスが中心ですが、バッチ処理やOLAP/BIはシーケンシャルアクセスのニーズが高くなります。
データストアを選択する上で重要なのは、ランダムアクセス性能とシーケンシャルアクセス性能は、多くの場合相反する性質ということです。このため、アプリケーションの特性に応じてデータストア製品を選択するが必要となります。あるいは、RDBMSにおけるインデックスのチューニングといった作業で同じデータベースシステムをシーケンシャルアクセス向けやランダムアクセス向けにチューニング仕分けることも可能です。いずれかの手段で、適切なデータストアを確保することになります。
アクセスサイズ
アクセスサイズとして以下の分類を使用します。
- record
- データをレコード単位でアクセス
- portion
- データの一定範囲をアクセス
- bulk
- データの一定範囲/全体を一括してアクセス
recordはレコード単位でのデータアクセスです。1レコードから数レコードの範囲を想定しています。
portionは一定範囲でのデータアクセスです。データの選択を行った後、一回の転送で取得できる範囲(1000件程度)を想定しています。
bulkはデータの一定範囲あるいは全体を一括アクセスします。データ全体スキャンあるいは選択条件に合致する多量のレコードを一括してアクセスすることを想定しています。
2011年4月15日金曜日
ユースケース
コラボレーションタスク監視起票は、Twitterでの注目発言の発生を監視し、注目発言が発生したときに、この発言に対応するためのタスクを起票するコラボレーションです。
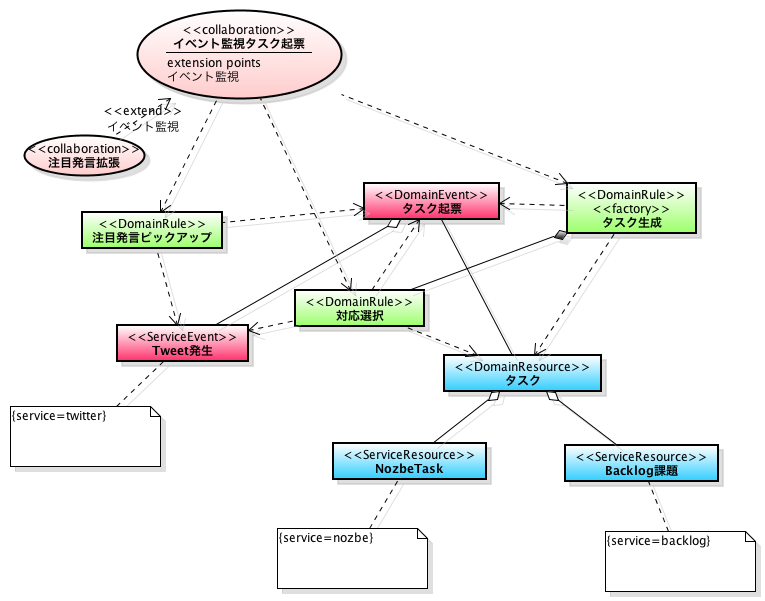
アプリケーション開発におけるモデリング作業の中でこのコラボレーションをどのように抽出してくるのかというのが論点の一つになります。これは、利用者の要求とコラボレーションの結びつけるモデル要素が必要なことを意味しています。
いうまでもなく、このモデル要素とはユースケース(use case)です。ユースケースは、システムの振舞いモデルであると同時に利用者の目的と、目的を達成するための物語を記述したモデル要素です。
ユースケースは、アクターの目的をアクターとシステム間のインタラクションの列として記述します。通常は、自然言語によるシナリオとしてこのインタラクションを記述します。
UMLでは、ユースケースを具象化したものがコラボレーション、コラボレーションを抽象化したものがユースケースという関係になります。
以下の図はコラボレーションイベント監視タスク起票を利用者の要求と結びつけるユースケースであるユースケースイベントを監視して対応するタスクを起票するを追加したものです。ユースケースイベントを監視して対応するタスクを起票するは、利用者視点での利用者とシステムのインタラクションをシナリオとして記述します。
そして、コラボレーションイベント監視タスク起票はこのユースケースイベントを監視して対応するタスクを起票するを実現(realize)する、という関係(relationship)になるわけです。(UMLでは、ユースケースをコラボレーションが実現するという関係を、実現シンボル(典型的にはインタフェースをクラスが実現の用途で使用)で記述できるのですがJudeではサポートしていないようなので、依存(dependency)で記述しています。)

開発の手順としては、問題領域のドメインモデルをざっくりと作りつつ、利用者の要求をユースケースとしてモデル化。ユースケースを実現するためにドメインモデルを調整、という流れになります。
ここで、ユースケースとドメインモデルをつなぐモデル要素としてコラボレーションが登場することになります。このコラボレーションをコードの自動生成の枠組みに結びつけることができれば、自動生成のターゲットが大きく広がります。
SimpleModelerでは、ユースケース、コラボレーションをScala DSLで記述して、(同じくScala DSLで記述した)ドメインモデルと結びつけるような方向でユースケースからコラボレーションを経てドメインモデルに至るトータルなモデリングプラットフォームを提供したいと考えています。
ユースケース周りは、ロバストネス分析など色々とおもしろい話題があるので、SimpleModelingでの扱い、SimpleModelerでのサポート方針といった切り口でブログでも取り上げていきたいと思います。
登録:
投稿 (Atom)

 投稿